Article partenaire
Attaques par déni de service : les entreprises face au risque de l’effet « boîte noire »
La majorité des entreprises estiment être bien protégées contre les attaques par déni de services (DDoS). Mais les informations auxquelles elles accèdent restent souvent parcellaires. Simon Bonin, expert cybersécurité pour IMS Networks, analyse le risque que ces situations font peser aux organisations.
IMS Networks
Sur cette page, découvrez IMS Network : articles publiés, contenus vidéos, équipes...
Simon Bonin
Expert sécurité - IMS Networks
Quelle place tient la protection DDoS dans les entreprises ? Celles-ci en maîtrisent-elles bien le fonctionnement ?
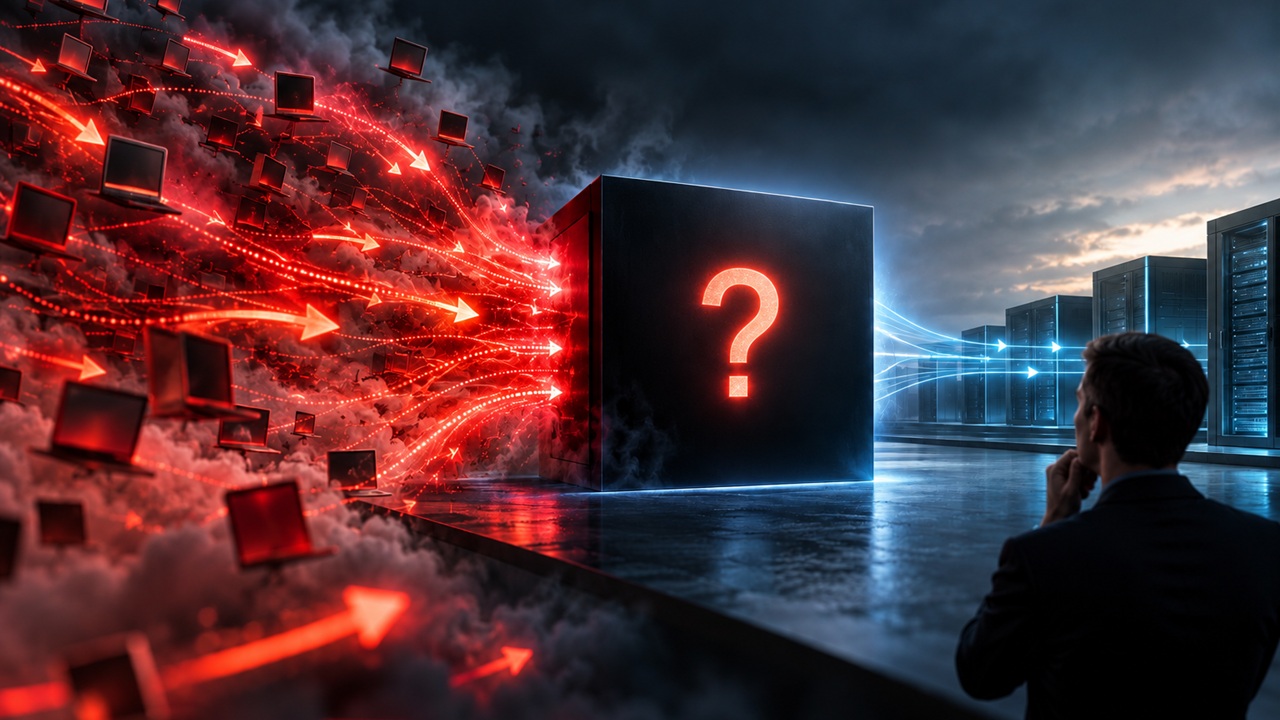
La protection DDoS est souvent présente, mais pas toujours réellement maîtrisée. Nous l’avons constaté auprès de clients qui disposaient déjà d’une solution chez un autre opérateur ou hébergeur. Elle était en place, intégrée dans une offre plus large de type « bundle », et le client disposait souvent d’un seul et unique graphe indiquant le volume de trafic rejeté ou une attaque en cours, mais sans beaucoup plus de détails, ni même sur le volume maximum contractuel qui peut être géré par ce fournisseur/hébergeur.
Quand nous demandions, dans une logique de réversibilité, des informations sur les seuils configurés ou sur des attaques passées, les éléments disponibles étaient assez pauvres. Les paramètres avaient été définis par défaut par l’opérateur et le client avait peu de possibilités de les modifier ou même de comprendre précisément comment ils fonctionnaient.
Tous les clients n’ont cependant pas besoin du même niveau de détail. Certains veulent surtout être protégés et recevoir un rapport lorsqu’une attaque survient. D’autres ont un SOC (security operation center), connaissent bien leur réseau et veulent comprendre quels protocoles ont été visés, quels flux ont déclenché la protection, quels volumes ont été observés ou si l’attaque était multivecteur…
Pour quelles raisons le fait d’avoir une protection DDoS « boîte noire » pose-t-il problème concrètement ? Quels sont les cas de figure où cela devient un risque ?
Le principal problème est qu’une approche très standardisée peut empêcher de comprendre les effets de bord et d’améliorer la protection après une attaque. Aujourd’hui, les attaques sont souvent multivecteurs. Une grosse attaque volumétrique peut s’accompagner d’autres attaques, moins impressionnantes sur un graphe, mais tout aussi efficaces pour dégrader un service.
Si une solution se contente de présenter l’existence d’une attaque, avec un débit entrant et un débit nettoyé, il devient difficile de savoir ce qui a réellement posé problème. Sur cinq vecteurs d’attaque, quatre ont peut-être été parfaitement bloqués et un seul a provoqué la dégradation. Sans granularité, le client ne le sait pas et risque d’ajuster sa protection un peu au hasard.
La boîte noire devient également problématique lorsque le fonctionnement même de la protection est mal compris. Certaines solutions détectent une attaque puis redirigent le trafic vers un scrubbing center, pour l’absorber et la « nettoyer ». Cela peut être efficace, mais il y a aussi des cas où cela ne l’est pas du tout. Par exemple, si l’on modifie uniquement la résolution DNS d’un site web vers de nouvelles adresses IP (pour pointer sur les scrubbing centers du fournisseur) alors que l’attaquant cible directement les IP publiques d’origine, il peut continuer à contourner la protection tant que ces IP restent accessibles et routées sur Internet. De plus, la redirection peut parfois être réalisée à travers des tunnels GRE vers les scrubbing centers du fournisseur de service. Dans ce cas-là, la capacité de mitigation reste dépendante de l’accès à Internet du client et pas vraiment du débit maximum que peut présenter le fournisseur sur les capacités maximales de ses scrubbing centers.
Autre risque : raisonner uniquement en très gros volumes. Une offre peut annoncer une capacité de mitigation de plusieurs dizaines de térabits par seconde, alors que l’attaque qui fera tomber le service sera bien plus faible. Un serveur ancien ou peu dimensionné peut s’écrouler avec quelques milliers de requêtes par seconde, un volume qu’une configuration standard ne considérera pas forcément comme significatif.
À quel point faut-il laisser la main au client-utilisateur, sur un sujet qui peut s’avérer technique ?
Il faut proposer plusieurs niveaux. Offrir toute la granularité à tout le monde n’a pas forcément de sens. Dans notre cas, nous avons donc deux niveaux de visualisation. Une première console, assez simple, permet de voir les volumes web, DNS, la répartition du trafic, ce qui entre, ce qui sort et ce qui est rejeté. Pour beaucoup de clients, cela suffit.
Mais nous proposons aussi une deuxième console beaucoup plus détaillée : applications, principales IP sources, types de flux, attaques détectées ou requêtes DNS anormales/malformées. C’est celle que nous utilisons nous-mêmes pour analyser une attaque. Cette deuxième option nécessite toutefois une formation minimale.
Le bon niveau se détermine généralement pendant des ateliers avec les équipes utilisatrices. Si le client maîtrise la première interface et commence à poser des questions plus précises, nous pouvons ouvrir l’accès à la seconde. L’idée est de ne pas complexifier le service inutilement, mais de ne pas enfermer non plus les clients les plus matures dans une protection sur laquelle ils n’auraient aucune maitrise.
Faut-il un seuil minimum de compétences et de moyens pour pouvoir bien exploiter des protections DDoS plus transparentes et paramétrables ?
Oui, si l’on veut réellement exploiter les fonctions avancées. Le client doit avoir une certaine compréhension de ses applications, de son réseau et des grandes typologies d’attaques DoS et DDoS. Sinon, la quantité d’informations disponible peut devenir contre-productive : on peut croire à tort qu’un trafic normal est une attaque.
En revanche, il n’est pas nécessaire d’avoir un SOC ou une équipe très importante pour bénéficier d’une protection plus granulaire. Pour les clients moins matures, nous pouvons aussi appliquer nos « templates » et nos bonnes pratiques, puis ajuster dans le temps. Les applications web, DNS et les flux entrants classiques permettent déjà de construire une base solide.
La différence apparaît surtout avec les environnements complexes, quand il existe dans le SI beaucoup d’API, des partenaires qui sollicitent fortement certaines applications via des scripts, des données critiques ou des exigences de disponibilité particulières. Plus le client connaît précisément ses flux, plus nous pouvons segmenter les services et ajuster les seuils.